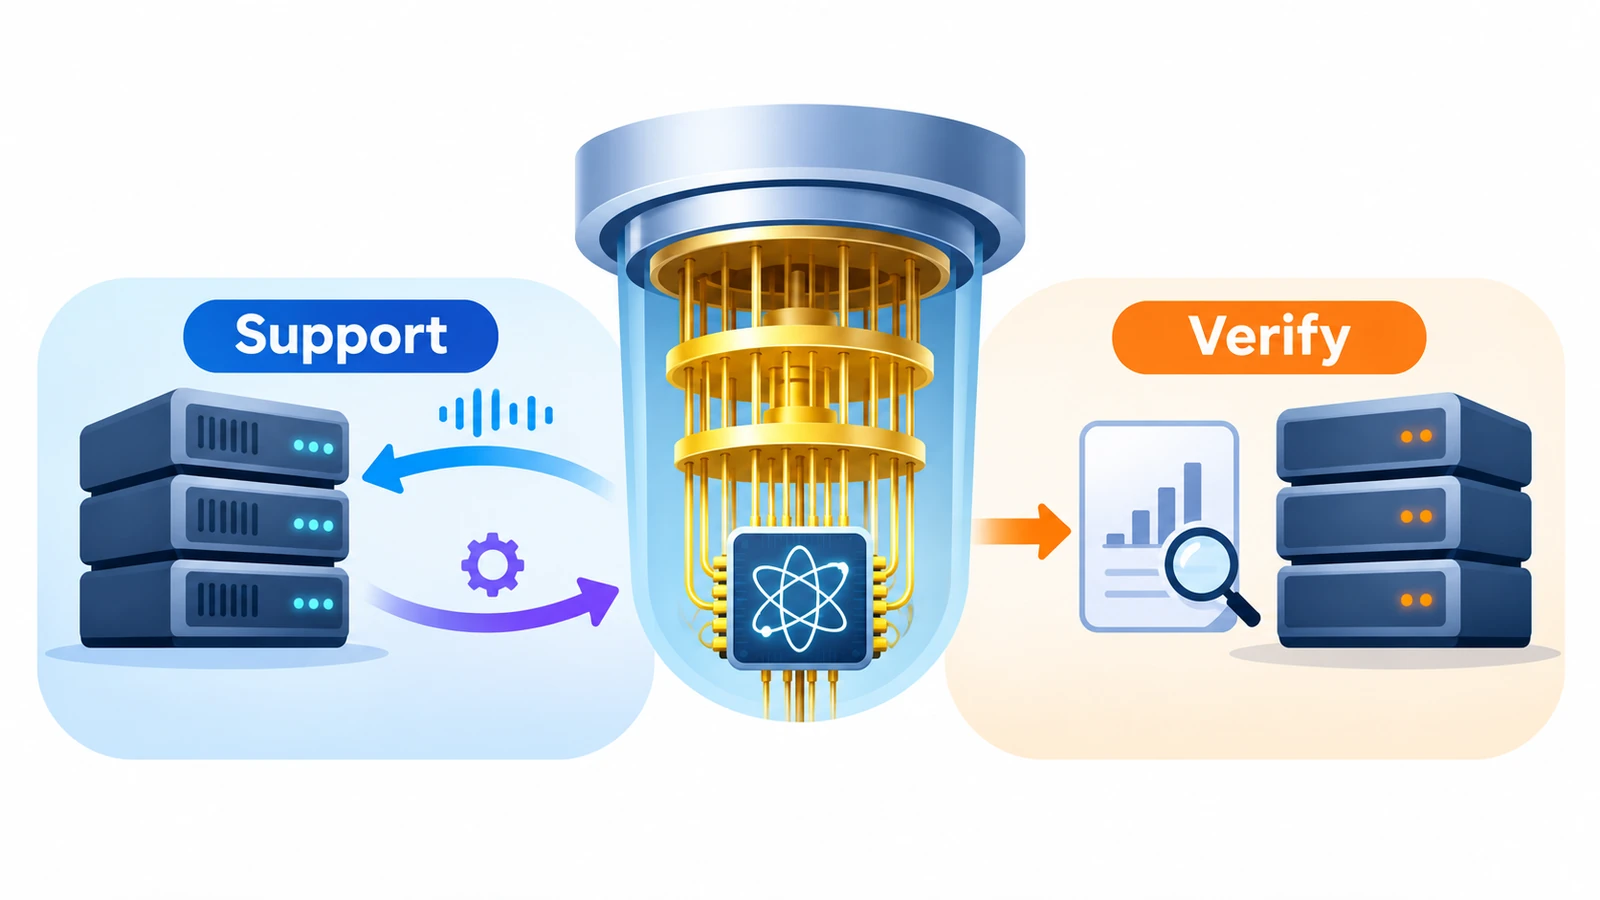
量子计算机要可靠地执行计算,也离不开其他计算机协助处理错误。11月5日,量子计算机开发企业IBM与美国橡树岭国家实验室、半导体公司AMD共同发布了一个研究平台:量子计算机和高性能计算机被部署在纽约州波基普西的同一设施内。这样的布局旨在减少两套系统交换数据时的延迟,并研究如何将错误解码与量子芯片的控制衔接起来。1
研究人员把我们日常使用的数字计算机称为“经典计算机”。最先进的超级计算机也属于这一类。量子计算机试图超越的对手,同时也可能是帮助它完成计算的伙伴。
谁来解读量子计算机的错误信号?
普通数字计算机使用以0和1表示的“比特”处理信息。量子计算机则使用“量子比特”,它可以处于与0和1对应的两种状态的叠加态。实际构建在量子芯片上的“物理量子比特”,即使受到微小扰动,也可能发生错误。
为了减轻错误的影响,研究人员把需要保护的信息“编码”在多个物理量子比特的状态中。这样受到保护的一个信息单元称为“逻辑量子比特”。研究人员不直接测量需要保护的量子信息,而是通过测量物理量子比特之间的关系,获取可能发生错误的线索。
分析这些线索并判断如何应对的程序或设备,称为“解码器”。利用解码结果减轻错误影响、保护编码信息的技术,就是“量子纠错”。如果下一步运算需要据此调整控制操作,解码器必须及时给出判断。
IBM于11月发布的平台将其超导量子处理器“Nighthawk R2”与橡树岭国家实验室的高性能计算机“Umbra”部署在一起。Umbra使用AMD的CPU以及擅长并行处理大量计算任务的GPU。三家机构计划研究如何由经典计算机处理量子芯片的错误信息,并将处理结果用于控制量子处理器。
IBM在11月5日的公告中介绍了共同部署的研究设施和低延迟协同设计。整套系统从错误解码到反馈控制的耗时,以及逻辑错误率的降低幅度,仍需后续研究测量。
错误解码也有截止时间
评价解码器性能时,既要看它能够处理多少错误信息,也要看它返回判断所需的时间。
6月,量子纠错技术公司Riverlane与超导量子计算机制造商Rigetti的联合研究团队测量了这一响应时间。研究人员将基于FPGA的解码器集成到Rigetti设备的控制系统中。FPGA是一种可以根据具体任务配置内部电路的芯片。
在使用8个物理量子比特的试验中,研究人员完成了9轮错误相关测量。最后一轮测量结束后,解码结果用于控制物理量子比特,这一过程共耗时9.6微秒。1微秒等于百万分之一秒。其中,解码用了6.5微秒,通信和控制用了3.1微秒。2
这一数据来自Riverlane与Rigetti的8量子比特试验。实际系统适合采用哪种解码器,取决于错误信息的规模和允许的响应时间。
经典计算方法的反击
经典计算机还有另一项任务:利用改进的经典算法检验“量子优势”的主张。
7月,IBM与芝加哥大学的量子实验团队报告称,他们使用70个逻辑量子比特运行了一个特定电路,在16.1分钟内收集到2,051个通过错误检查的输出结果。IBM认为,按照当时已知的主要经典算法,这项任务很难处理,因此主张实现了量子优势。“量子优势”指量子计算机在某一特定计算任务上相对于经典计算机具有优势。3
8月,Manabe、Gu和Pan等研究人员提出了一种用经典计算机分析该电路的新方法。他们调整了计算中各部分结果的合并顺序,减少了存储中间结果所需的内存。通过优化“张量网络计算”,他们求出了IBM此前公布的各个输出结果的出现概率。
Manabe、Gu和Pan团队报告称,用256块GPU计算这些已公开输出结果的概率,耗时37.3分钟。IBM的16.1分钟用于生成新的输出结果;经典计算团队的37.3分钟用于计算既有输出结果的概率。4
量子比特减少,经典算法面临新考验
9月发布的IBM与芝加哥大学量子实验论文修订版采用了一个新电路。逻辑量子比特之间的运算关系,从7月采用的“开链结构”变成了“环形结构”。5
逻辑量子比特的数量从70个降至64个。然而,对于Manabe、Gu和Pan团队针对开链结构提出的经典计算方法,环形电路更难处理。计算难度不仅取决于量子比特数量,也受到运算连接方式的影响。
8月发表经典计算研究的Manabe、Gu和Pan三人,也出现在9月修订版论文的共同作者名单中。9月22日,加拿大计算资源机构Calcul Québec的研究人员Kim Renaud在公开平台“Quantum Advantage Tracker”提交报告,介绍利用CPU计算环形电路已公开输出结果概率的工作。6
验证结果同样需要付出代价
当经典计算机难以求出量子实验所有可能输出的概率时,研究人员该如何评估实验的准确性?
在7月的实验中,IBM与芝加哥大学的研究人员采用了“后选择”:舍弃错误检查显示异常的实验运行,只分析通过检查的输出结果。
研究团队结合错误检查结果和较容易验证的基准电路测量结果,估计了一个“保真度下界”。在特定的错误和噪声假设、给定的统计置信水平下,这一下界用于估计所得量子态与目标态之间的最低保真度。
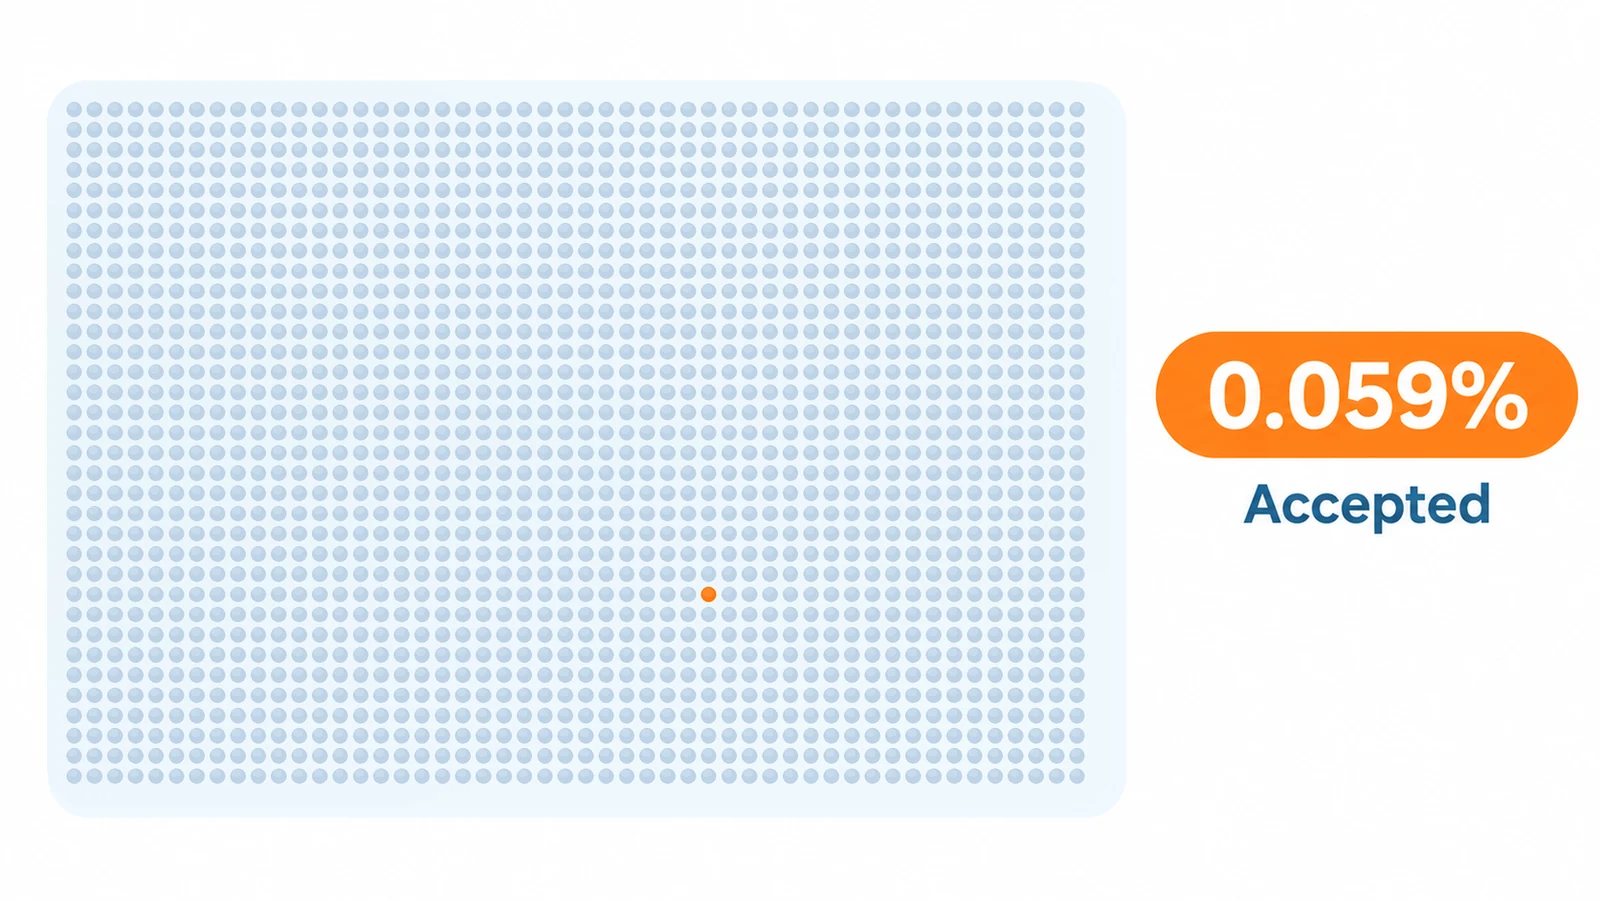
但在7月的实验中,通过错误检查的运行只占总数的约0.059%。为获得可用结果,研究人员不得不舍弃大量实验运行。因此,比较量子计算机性能时,也必须计入这部分时间和硬件资源。7
胜负要看整个系统
承担错误解码任务的经典计算机,必须在量子芯片进行下一步控制之前给出判断。与此同时,经典算法的进步也意味着量子优势的主张需要接受新方法的再次检验。经典计算机既帮助量子芯片处理错误,也凭借改进的经典算法成为检验量子优势的对手。
因此,量子计算机的成绩单不能只记录量子芯片的运行时间。错误解码消耗的资源、错误检查中被舍弃的运行,以及验证结果的成本,都应纳入考量。与经典计算方法比较时,还必须采用相同的任务和准确度要求。
对11月启动的IBM、橡树岭与AMD研究平台,研究人员需要同时测量错误信息的处理时间、结果反馈到控制系统的时间、相关资源消耗,以及逻辑错误率的改善幅度。
评价量子计算的竞争力,需要把经典计算辅助和结果验证各自的成本都算进去,再比较完整的量子—经典系统与纯经典方案在同一问题、同一准确度要求下的效率。
脚注
1. Rafi Letzter, “ORNL, IBM, and AMD launch co-design platform for quantum error correction,” IBM Quantum,2026年11月5日。另见IBM、橡树岭与AMD联合公告。公告介绍了位于波基普西的IBM量子处理器与橡树岭Umbra高性能计算机的共同部署,以及面向低延迟协同研究的平台。
2. Laura Caune, Luka Skoric, Nick S. Blunt et al., “Demonstrating real-time and low-latency quantum error correction with superconducting qubits,” Nature Communications 17, 7383 (2026)。Riverlane与Rigetti在8个物理量子比特上的试验中,于9轮测量结束后记录了解码6.5微秒、通信和控制3.1微秒。
3. IBM与芝加哥大学,“IBM and The University of Chicago Demonstrate Quantum Advantage”,2026年7月30日。原论文为Simon Martiel et al., “Sampling hard circuits with verifiably high fidelity,” arXiv:2607.25941v1(2026年7月28日)。研究人员在16.1分钟内收集到2,051个经后选择保留的输出结果。“量子优势”是IBM当时提出的主张。
4. Hidetaka Manabe, Hanfeng Gu, Feng Pan, “Classical Simulation and Design Frontiers for IBM’s Doped Clifford Sampling Experiment,” arXiv:2608.13110(初版2026年8月13日,修订2026年10月29日)。37.3分钟是使用256块GPU批量计算IBM已公开的2,051个输出结果的振幅与概率所报告的实际时间。
5. Simon Martiel et al., “Sampling hard circuits with verifiably high fidelity,” arXiv:2607.25941v3(2026年9月2日)。修订版报告了具有64个逻辑量子比特、76个物理量子比特、深度73及314个T门的电路,Hidetaka Manabe、Hanfeng Gu、Feng Pan也被列为共同作者。量子优势追踪论坛的电路提交记录也涉及该逻辑环形结构。核查范围: 64个逻辑量子比特、76个物理量子比特、电路修订和作者名单,已经与公开摘要及书目信息交叉核对。保真度下界0.349(95%置信水平)是论文作者依据特定噪声模型和统计估计报告的数值。由于未能直接获取v3修订版的方法(Methods)部分和补充材料全文,具体校正程序、噪声模型假设及统计评估条件尚未经过独立的全面核验。
6. Kim Renaud, “injected_graph_scan_nq64_depth73,” Quantum Advantage Tracker,公开提交#249(2026年9月22日)。该提交报告了使用经典CPU计算修订电路1,389个已公开输出结果概率的工作。这是一项公开提交记录,并非经过同行评审的论文。
7. Simon Martiel et al., “Sampling hard circuits with verifiably high fidelity,” arXiv:2607.25941v1(2026)。初版相关实验通过错误检查的比例为5.90(5)×10⁻⁴(约0.059%)。研究仅分析了后选择后保留的输出结果。
继续阅读 CAUSIFOLD
在 Substack 关注 CAUSIFOLD 的新文章与动态。
在 Substack 订阅 ↗