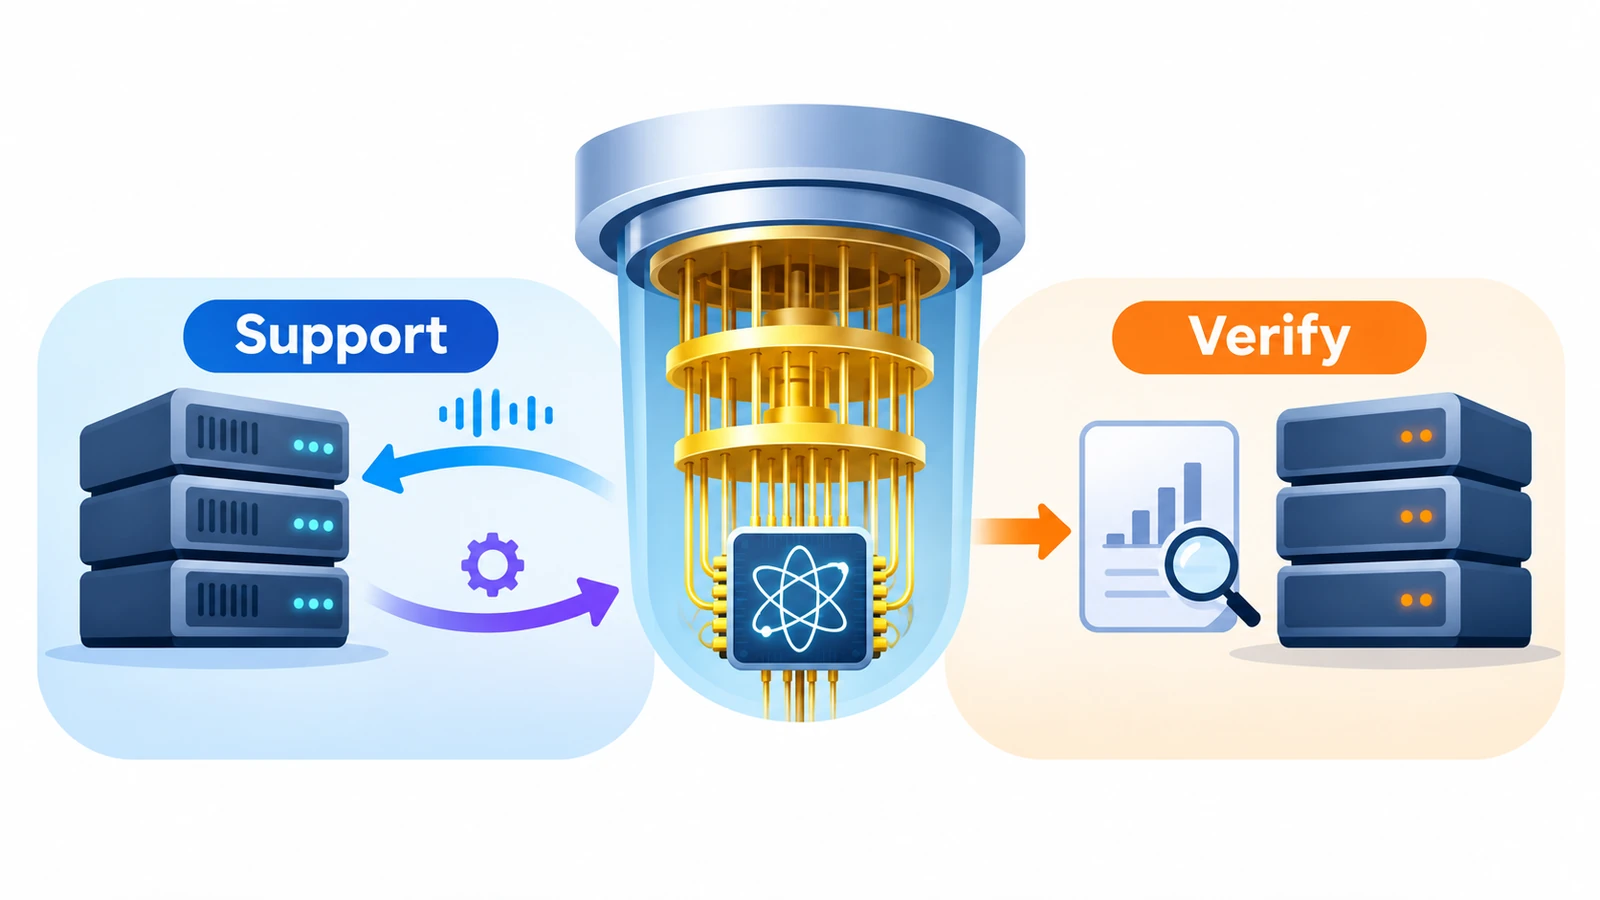
Incluso una computadora cuántica necesita ayuda de otras computadoras para gestionar los errores que pueden afectar sus cálculos. El 5 de noviembre, IBM presentó junto con el Laboratorio Nacional de Oak Ridge, en Estados Unidos, y la empresa de semiconductores AMD una plataforma de investigación en Poughkeepsie, Nueva York. La plataforma sitúa una computadora cuántica y otra de alto rendimiento en una misma instalación, con el propósito de reducir la latencia del intercambio de datos y estudiar cómo integrar la decodificación de errores con el control del procesador cuántico.1
Los investigadores llaman computadoras clásicas a las máquinas digitales que utilizamos a diario. Incluso las supercomputadoras más avanzadas pertenecen a esa categoría. Las computadoras clásicas son a la vez posibles competidoras de las cuánticas y herramientas que ayudan a hacerlas funcionar.
¿Cómo se interpretan los errores de una computadora cuántica?
Las computadoras digitales convencionales procesan información mediante bits, representados por ceros y unos. Las computadoras cuánticas utilizan cúbits, capaces de estar en una superposición de los estados asociados al cero y al uno. Los cúbits físicos, implementados en el propio chip, pueden sufrir errores por perturbaciones muy pequeñas.
Para reducir esos errores, los investigadores codifican la información que desean proteger en los estados de varios cúbits físicos. Cada unidad de información protegida de este modo se denomina cúbit lógico. Al medir las relaciones entre los cúbits físicos, en lugar de medir directamente la información cuántica protegida, se obtienen indicios de posibles errores.
El programa o dispositivo que interpreta esos indicios y determina una respuesta se llama decodificador. La técnica que utiliza esa información para reducir los efectos de los errores y proteger la información codificada se conoce como corrección de errores cuánticos. Si la respuesta debe modificar el control de la siguiente operación, el decodificador tiene que entregar su resultado a tiempo.
La plataforma que IBM presentó en noviembre reúne su procesador cuántico superconductor Nighthawk R2 y la computadora de alto rendimiento Umbra, del Laboratorio Nacional de Oak Ridge. Umbra utiliza CPU de AMD y GPU capaces de ejecutar numerosos cálculos en paralelo. Las tres organizaciones investigarán cómo procesar la información de errores con computadoras clásicas y utilizar el resultado para controlar el procesador cuántico.
El anuncio de IBM del 5 de noviembre describió la instalación y el diseño para una integración de baja latencia. El tiempo total necesario para decodificar los errores y aplicar el control, así como la posible reducción de la tasa de errores lógicos, son parámetros que deberán medirse en estudios posteriores.
La decodificación de errores tiene un límite de tiempo
Para evaluar un decodificador hay que considerar tanto el volumen de información que procesa como el tiempo que tarda en devolver una decisión.
En junio, un equipo conjunto de Riverlane, empresa especializada en corrección de errores cuánticos, y Rigetti, fabricante de computadoras cuánticas superconductoras, midió ese tiempo de respuesta. Los investigadores integraron un decodificador basado en un dispositivo FPGA en el sistema de control de Rigetti. Un FPGA es un circuito integrado cuya configuración interna puede adaptarse a tareas concretas.
En una prueba con ocho cúbits físicos, el equipo completó nueve rondas de mediciones relacionadas con los errores. Entre el final de esas mediciones y la aplicación del control condicionado por la decodificación pasaron 9,6 microsegundos. Un microsegundo es una millonésima de segundo. La decodificación requirió 6,5 microsegundos y la comunicación y el control, otros 3,1.2
La medición corresponde al experimento de ocho cúbits de Riverlane y Rigetti. La elección de un decodificador para otros sistemas depende de la cantidad de información sobre errores que deba procesar y del tiempo de respuesta admisible.
La respuesta de la computación clásica
La computación clásica también permite poner a prueba las afirmaciones de ventaja cuántica mediante algoritmos más eficaces.
En julio, un equipo experimental de IBM y la Universidad de Chicago informó que había ejecutado un circuito específico con 70 cúbits lógicos y reunido 2.051 resultados que superaron los controles de errores en 16,1 minutos. IBM afirmó que la tarea era difícil para los principales métodos clásicos conocidos entonces y sostuvo que había alcanzado una ventaja cuántica. El concepto se refiere a una ventaja de las computadoras cuánticas en una tarea computacional específica.3
En agosto, Manabe, Gu y Pan propusieron una nueva forma de analizar ese circuito mediante computación clásica. Al cambiar el orden en que se combinaban las distintas partes del cálculo, redujeron la memoria necesaria para almacenar resultados intermedios. Mediante un cálculo con redes tensoriales optimizado, obtuvieron la probabilidad de cada resultado publicado por IBM.
El equipo de Manabe, Gu y Pan informó que utilizó 256 GPU y tardó 37,3 minutos en calcular esas probabilidades. Los 16,1 minutos de IBM corresponden a la generación de nuevos resultados; los 37,3 minutos del equipo clásico corresponden al cálculo de probabilidades de resultados ya conocidos.4
Menos cúbits, un nuevo desafío para los algoritmos
La versión revisada del artículo experimental de IBM y la Universidad de Chicago, publicada en septiembre, introdujo un circuito nuevo. Las relaciones entre las operaciones de los cúbits lógicos cambiaron de una cadena abierta, como la utilizada en julio, a una estructura en anillo.5
El número de cúbits lógicos se redujo de 70 a 64. Sin embargo, el circuito en forma de anillo resultaba más difícil para el método clásico que el equipo de Manabe, Gu y Pan había propuesto para la cadena abierta. La dificultad del cálculo depende tanto del número de cúbits como de la forma en que se conectan las operaciones.
La revisión de septiembre incorporó como coautores a Manabe, Gu y Pan, responsables del análisis clásico publicado en agosto. El 22 de septiembre, Kim Renaud, de la organización canadiense de computación Calcul Québec, presentó en el foro público Quantum Advantage Tracker un informe sobre el cálculo con CPU de las probabilidades de resultados ya publicados del circuito en anillo.6
Verificar los resultados también cuesta
Si las computadoras clásicas no pueden calcular con facilidad la probabilidad de todos los resultados posibles, ¿cómo se puede evaluar la precisión de un experimento cuántico?
En el experimento de julio, los investigadores de IBM y la Universidad de Chicago recurrieron a la postselección: descartaron las ejecuciones en las que los controles detectaron indicios de error y analizaron únicamente los resultados que superaron esas comprobaciones.
El equipo estimó una cota inferior de fidelidad a partir de los controles de errores y las mediciones de circuitos de referencia que eran más fáciles de verificar. Bajo determinados supuestos sobre errores y ruido, y con un nivel de confianza estadística establecido, esa cota estima el grado mínimo de fidelidad respecto del estado cuántico objetivo.
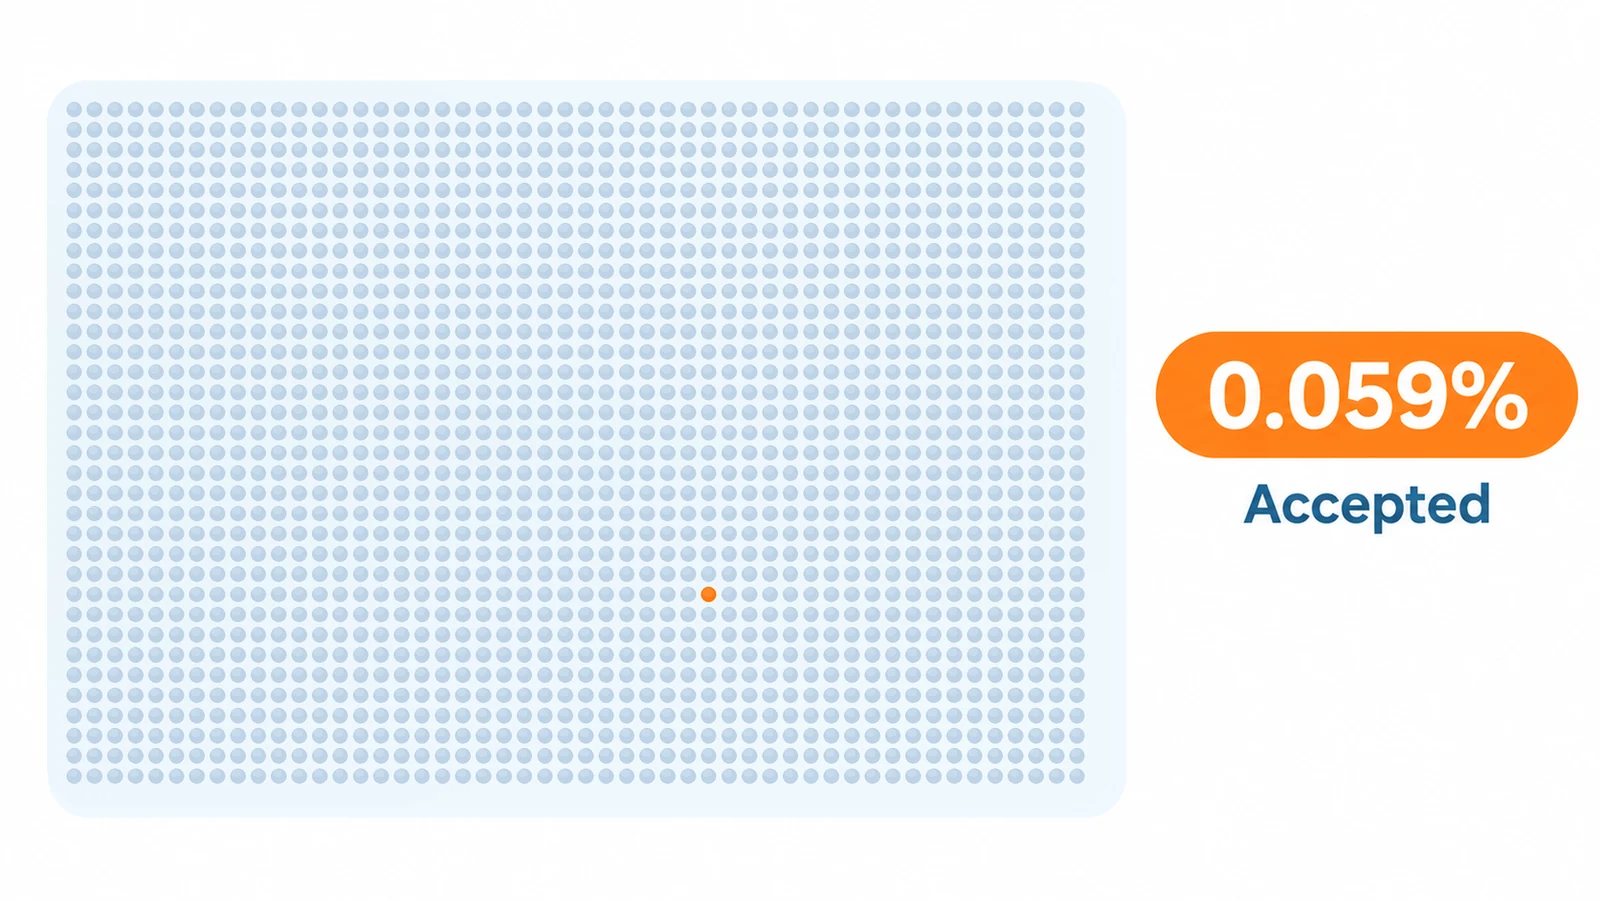
Sin embargo, solo alrededor del 0,059 % de las ejecuciones del experimento de julio superaron los controles de errores. Obtener resultados utilizables exigía descartar muchas ejecuciones. Por eso, al comparar el rendimiento de una computadora cuántica también hay que contabilizar el tiempo y los recursos materiales consumidos en ese proceso.7
El resultado depende del sistema completo
La computadora clásica encargada de decodificar errores debe entregar su resultado a tiempo para la siguiente operación de control del chip cuántico. Al mismo tiempo, cuando mejoran los algoritmos clásicos, las afirmaciones de ventaja cuántica deben examinarse de nuevo a la luz de esos avances. Las computadoras clásicas ayudan a operar los sistemas cuánticos y, con algoritmos más eficaces, también sirven de referencia para evaluar las afirmaciones de ventaja cuántica.
Por tanto, el rendimiento de una computadora cuántica no puede evaluarse solo por el tiempo de ejecución del chip. Debe incluir los recursos destinados a decodificar errores, las ejecuciones descartadas durante los controles y el costo de verificar los resultados. Las comparaciones con métodos clásicos también deben emplear la misma tarea computacional y los mismos requisitos de precisión.
En la plataforma de IBM, Oak Ridge y AMD presentada en noviembre habrá que medir conjuntamente el tiempo que lleva procesar la información sobre errores, el necesario para aplicar el control correspondiente, los recursos utilizados y la reducción de la tasa de errores lógicos.
Para evaluar la competitividad de la computación cuántica hay que comparar el sistema completo, incluidos los costos de la asistencia clásica y de la verificación de resultados, con una solución exclusivamente clásica que resuelva el mismo problema con igual precisión.
Siga leyendo CAUSIFOLD
Siga los nuevos artículos y novedades de CAUSIFOLD en Substack.
Suscribirse en Substack ↗Notas
1. Rafi Letzter, “ORNL, IBM, and AMD launch co-design platform for quantum error correction,” IBM Quantum, 5 de noviembre de 2026. Véase también el comunicado conjunto de IBM, Oak Ridge y AMD. Describe la instalación conjunta del procesador cuántico de IBM y Umbra, del laboratorio de Oak Ridge, en Poughkeepsie, y la plataforma de investigación de baja latencia.
2. Laura Caune, Luka Skoric, Nick S. Blunt et al., “Demonstrating real-time and low-latency quantum error correction with superconducting qubits,” Nature Communications 17, 7383 (2026). En el experimento de ocho cúbits físicos de Riverlane y Rigetti se midieron 6,5 microsegundos de decodificación y 3,1 de comunicaciones y control, después de nueve rondas de medición.
3. IBM y la Universidad de Chicago, “IBM and The University of Chicago Demonstrate Quantum Advantage,” 30 de julio de 2026. Artículo original: Simon Martiel et al., “Sampling hard circuits with verifiably high fidelity,” arXiv:2607.25941v1 (28 de julio de 2026). Se reunieron 2.051 resultados conservados tras la postselección en 16,1 minutos. La «ventaja cuántica» es una afirmación realizada entonces por IBM.
4. Hidetaka Manabe, Hanfeng Gu y Feng Pan, “Classical Simulation and Design Frontiers for IBM’s Doped Clifford Sampling Experiment,” arXiv:2608.13110 (primera versión del 13 de agosto de 2026; revisión del 29 de octubre). El tiempo medido de 37,3 minutos corresponde al cálculo por lotes de amplitudes y probabilidades de los 2.051 resultados de IBM ya publicados mediante 256 GPU.
5. Simon Martiel et al., “Sampling hard circuits with verifiably high fidelity,” arXiv:2607.25941v3 (2 de septiembre de 2026). La versión revisada describe un circuito de 64 cúbits lógicos, 76 físicos, profundidad 73 y 314 puertas T, e incorpora a Hidetaka Manabe, Hanfeng Gu y Feng Pan como coautores. La presentación del circuito en el foro de seguimiento de la ventaja cuántica también documenta su topología lógica en anillo. Alcance de la verificación: Se contrastaron los 64 cúbits lógicos, los 76 físicos, la revisión del circuito y la lista de autores con el resumen público y el registro bibliográfico. La cota inferior de fidelidad de 0,349 (95 % de confianza) es una cifra comunicada por los autores bajo un modelo de ruido y una estimación estadística determinados. No se tuvo acceso directo al texto completo de Methods ni al material suplementario de v3, por lo que no se pudieron verificar íntegramente y de forma independiente los procedimientos de corrección, los supuestos del modelo ni las condiciones estadísticas de la estimación.
6. Kim Renaud, “injected_graph_scan_nq64_depth73,” Quantum Advantage Tracker, presentación pública n.º 249 (22 de septiembre de 2026). El registro describe cálculos con CPU de las probabilidades correspondientes a 1.389 resultados ya publicados del circuito revisado. Se trata de una presentación pública y no de un artículo revisado por pares.
7. Simon Martiel et al., “Sampling hard circuits with verifiably high fidelity,” arXiv:2607.25941v1 (2026). La proporción de ejecuciones que superó los controles de errores en el experimento pertinente fue de 5,90(5) × 10⁻⁴ (aproximadamente 0,059 %). Solo se analizaron los resultados conservados tras la postselección.